AI 与硬件
K-Search 将 CUDA 内核优化经验迁移至 Apple Silicon MLX
完整中文导读
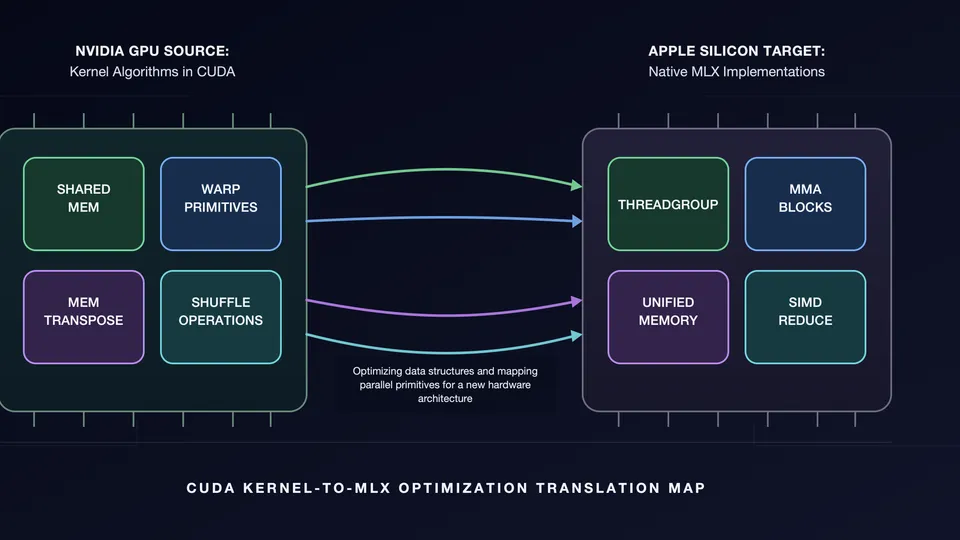
该工作扩展了伯克利 Sky Lab 的进化式内核搜索框架 K-Search,为其构建 MLX 后端,并设计结构化 CUDA-to-MLX 翻译层,将 CUDA 内核优化知识自动迁移到 Apple Silicon。在注意力内核上达到原生 MLX 内核 0.97 倍速度,在 Mamba SSM 内核上相比社区 mlx-lm 实现取得最高 20 倍预填充加速。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。