AI教育实践
MIT 课程 MAS.S62 两讲梳理 Harness 演化与多 Agent 演化
完整中文导读
MIT 课程 MAS.S62「How to AI an AI」的 Lecture 4-5 聚焦 Harness evolution,分别讲 harness 组件、记忆、工具与技能演化,以及规划、任务分解与多 agent 系统演化。
中文整理
作者 / 来源:meng shao (@shao__meng) · 原文时间:2026年10月20日 09:52(北京时间)
原作者信息要点
作者介绍 MIT 课程 MAS.S62「How to AI an AI」的 Lecture 4-5,主题分别为 Harness Evolution 与 Multi-Agent Evolution,并给出两讲 PDF 链接。
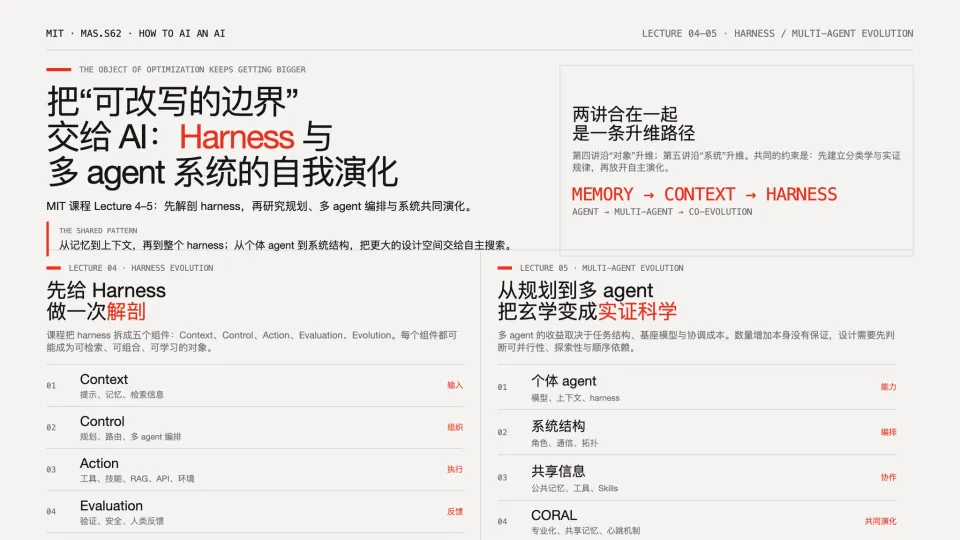
Lecture 4 将 Harness 解剖为五个组件:Context(提示、记忆、检索)、Control(规划、路由、多 agent 编排)、Action(工具、技能、RAG、API、环境)、Evaluation(验证、安全、人类反馈)、Evolution(反思、更新、学习)。记忆部分用三轴分类法(存什么、如何表示、存在哪里)加复用方式组织,并列举 MemGPT、mem0、MEM1、Reflexion/ExpeL 四个系统。作者称 MEM1 是授课者所在组的工作,让模型每步生成整合推理与记忆的内部状态并丢弃历史,上下文大小恒定,可用结果奖励端到端训练;实验出现三类未被显式编程的行为:分类存储关键信息、答完一题先更新记忆、多次搜索无果后跳过该题。
Context Language Models(CLM)把整个上下文当作文件,用 Bash 命令编辑并与真实上下文同步,创建或删除上下文文件即可实例化或终止子 agent。工具与 Skills 谱系为 Toolformer、ToolLLM(16000+ API)、CodeAct(称代码是元工具,实验显示用代码做工具调用成功率最高、交互轮数最少)、Skills 层(PolySkill、Agent Workflow Memory)、Voyager 的 Skills 库。Meta-Harness 把整个 harness 表示为文件系统,完整源代码、分数与全部执行轨迹都在其中,proposer(Claude Code,用 grep/cat 阅读)可把失败回溯到具体 harness 决策;作者称其反馈信息量约为此前方法的 400 倍(1000 万 token 对 2.6 万)。讲义末页的抽象阶梯为:MEM1 把记忆当作上下文内内部状态、CLM 把上下文当作持久文件、Meta-Harness 把 harness 当作文件系统,三者均由 LLM 自主更新。
Lecture 5 规划部分提出三个问题:规划何时有用或有害、计划如何表示、何时该改计划;结论称基于提示的规划适用于纯文本、无副作用、可回退场景,作用于真实世界且不可逆时须规划-执行-观察-重规划。多 agent 部分以 Towards a Science of Scaling Agent Systems(Nature Machine Intelligence 2026)为主线给出五条发现:多 agent 只对特定任务结构有效(金融 agent 任务 MAS 赢 81%,PlanCraft 类顺序依赖任务 MAS 输 70%);收益随基座模型而异;agent 数量越多不一定越好,工具密集型任务受协调开销拖累;异构混合可打败更强单一基座,且单 agent 基线已超 45% 时 MAS 反而有害;以模型、任务、MAS 配置为参数的 scaling law 能以 87% 准确率预测最优架构。多 agent 演化部分介绍 CORAL(作者称是本课 TA Ao Qu 的一作论文):多 agent 专业化、共享记忆、心跳机制,在数学、算法、系统优化等 8 个任务上取得新 SOTA,多 agent 演化比单 agent 提升 4%–20%;36% 的演化尝试以其他 agent 为父节点,这些尝试改进率 17%(平均 9%),各 agent 探索重叠度 Jaccard 0.3–0.4。
本站整理与观察
本站观察:这篇材料是对课程讲义与论文的二次梳理,并非课程官方文本;其中实验数字、系统名称与论文归属均来自作者转述,本站未独立核验。
本站观察:两讲的结构可概括为“先建立分类学与实证约束,再把剩余设计空间交给自主演化”——第四讲沿记忆、上下文、harness 逐级扩大可被 LLM 改写的对象,第五讲沿个体 agent、多 agent 编排、多 agent 系统演化逐级扩大自主搜索的设计空间。
本站观察:作者对多 agent 的叙述刻意保持克制,用五条实证发现与失败分析对冲“多 agent 更强”的流行叙事,这与第四讲强调“简单、无手工设计、端到端”的立场一致。
材料为作者对两讲讲义的个人梳理,含大量转述数字与论文归属(如 400 倍反馈信息量、87% 预测准确率、CORAL 的 4%–20% 提升与 17% 改进率),本站未核对原始讲义或论文;两讲 PDF 链接与推文链接仅为材料所载,未验证可访问性。本整理不构成对课程内容或研究结论的独立确认。
上下文来源:1
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。