AI教育实践
Prompt Caching 与 Semantic Caching 的区别:前者复用前缀计算,后者复用整条答案
完整中文导读
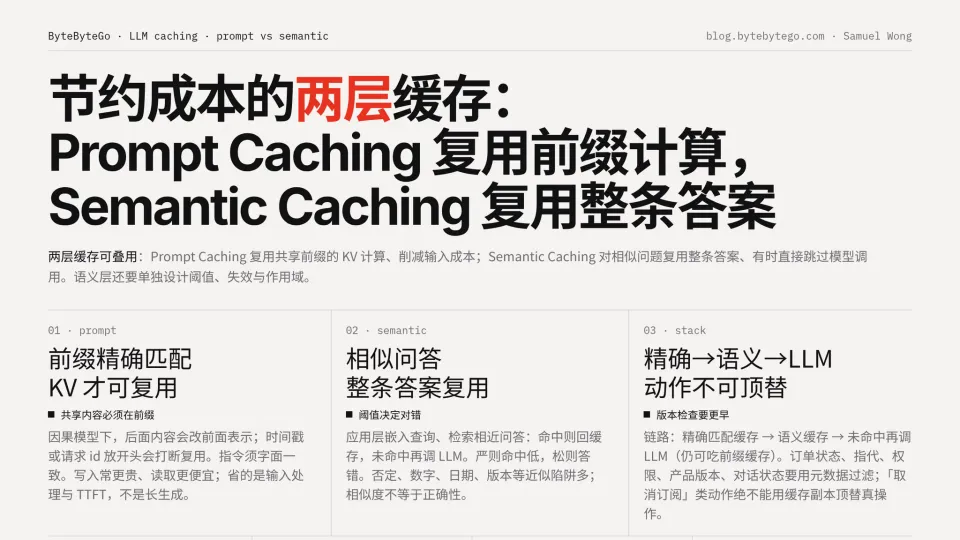
meng shao 转述 @samuel_wong_ 在 bytebytego 发布的内容,把 LLM 应用降本拆成两类缓存:Prompt Caching 复用共享前缀的 KV 计算,Semantic Caching 用嵌入向量检索相近历史问答、命中即跳过整次模型调用。
中文整理
作者 / 来源:meng shao (@shao__meng) · 原文时间:2026年10月22日 22:17(北京时间)
原作者信息要点
材料来自 @samuel_wong_ 在 @bytebytego 发布的内容,主题是 LLM 应用中的两类缓存:Prompt Caching 复用共享前缀的 KV 计算,Semantic Caching 复用语义相近问题的整条答案。前者降低输入成本,后者可能完全跳过模型调用;二者可叠加,但语义缓存的阈值、失效和适用范围需单独设计。
缓存动机:一次请求费用来自输入 token 和输出 token。客服类应用中,系统指令、产品手册、历史对话常远长于用户问题,重复出现在两处:同一长文档被反复送入模型,以及大量用户用不同措辞问同一件事。
Prompt Caching:匹配规则是输入开头完全一致;模型先 prefill 再 decoding,前缀 KV 状态可跨请求复用。共享内容必须放在前缀,时间戳、请求 ID 放在开头也会打断复用;指令须字面完全相同,措辞、文档顺序、请求设置都不能变。费用不会归零:文中引用 Anthropic 标准定价称缓存读约为普通输入的 1/10,5 分钟写为 1.25 倍,1 小时写为 2 倍;例如前缀原价 1 美元,一次写加一次读为 1.35 美元而非 2 美元。它主要省输入处理和首包等待时间,不省生成长答案的工作。
Semantic Caching:通常做在应用层或独立服务,用嵌入模型把问题变成向量,检索相近历史问答;命中直接返回缓存答案,未命中再调 LLM 并可能写入。命中跳过整次 LLM 调用,未命中多付一层嵌入与检索成本。难点是相似度阈值:严则命中率低,松则可能答错,相近但不该复用的例子包括发货前取消与发货后取消、Basic 套餐与 Pro 套餐,以及否定词、数字、日期、版本差异。相似度分数不等于正确概率,需用标注集评估阈值,并同时看命中率和答案合适率。
Semantic Caching 不能只看问题文本,订单状态、指代、语言、权限、产品版本、对话状态都要进元数据过滤。失效策略包括 TTL、版本号(整库失效或按依赖文档选择性失效),以及指令、格式、模型行为变更时的失效。Prompt cache 的失效不同:前缀一变,旧 KV 从变更点起不能用;但应用若继续塞旧政策进 prompt,缓存本身不会发现业务规则已变。
组合顺序建议:先精确匹配缓存,再语义缓存,未命中再走 LLM,并尽量吃到前缀缓存;需要校验源数据版本的检查应放在更前面。行动类请求(如“订阅已取消”)绝不能用缓存文案代替真实操作。选型上,Prompt Caching 适合共享手册、稳定工具定义、长对话历史但每个问题仍需新鲜答案;Semantic Caching 适合 FAQ、稳定说明,不适合强个性化、事实变化快或需要新鲜创意输出的场景。
本站整理与观察
本站观察:材料把两类缓存的核心差异落在复用对象上,Prompt Caching 复用输入前缀的 KV 计算,Semantic Caching 复用整条答案,这一区分与文中“不要混淆两者”的表述一致。
本站观察:材料给出的 Anthropic 定价比例和 1.35 美元示例属于原作者引用,本站未独立核验;实际费用应以所用服务商当前定价为准。
本站观察:材料强调语义缓存需元数据过滤和标注集评估阈值,但未给出具体阈值数值或评估指标定义,实施时需自行设计。
材料为对 @samuel_wong_ 帖子和 ByteByteGo 文章的转述,未提供原始实验数据、标注集规模或阈值评估结果;Anthropic 定价为文中引用,未经本站独立验证。本站观察仅基于材料推论,不构成实施建议。
上下文来源:1
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。