AI 与硬件
VeriFine:让策略与评判器共同进化的智能体框架
完整中文导读
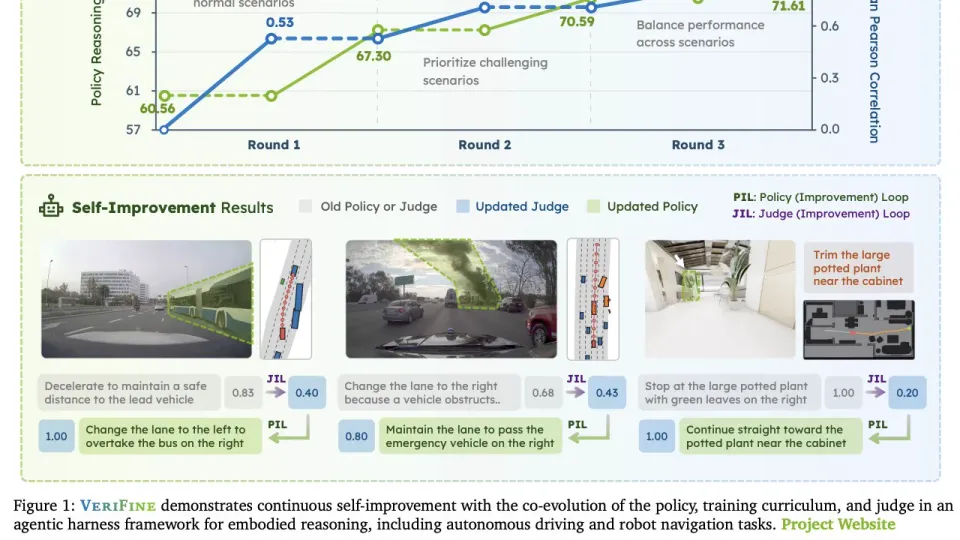
研究者提出 VeriFine,一个面向 Physical AI 的智能体框架,让策略、训练课程与评判器协同进化,而非在固定循环中只优化策略。该框架能识别策略失败并转化为训练信号,当评判器成为瓶颈时引入针对性人工反馈来改进评估。在自动驾驶与机器人导航任务上,通过强化学习和监督微调,策略与评判器能力均持续提升。
中文整理
作者 / 来源:Marco Pavone (@drmapavone) · 原文时间:2026年10月20日 05:56(北京时间)
原作者信息要点
Marco Pavone 介绍新论文 VeriFine,称其为面向 Physical AI 的 agentic harness(智能体框架),目标是让策略、训练课程与评判器共同持续进化。
作者提出的问题:AI 策略改进后会遇到新挑战并出现新的失败模式,评估它们的评判器也需要同步进化,否则会成为进一步进步的瓶颈;这在需要空间 grounding、因果推理和安全意识的 Physical AI 中尤为相关。
方法思路:构建能识别策略失败、把失败转化为有用训练信号并改进策略的智能体系统;当评判器本身成为瓶颈时,框架引入针对性人类反馈来修正其评估,并指导下一轮改进。
作者称在自动驾驶和机器人导航上评估 VeriFine,通过强化学习和监督微调,策略与评判器能力均持续提升。
作者的核心结论:这类 agentic harness 超越在固定循环中优化策略,而是调整改进过程本身,包括如何识别失败、如何选择训练数据、如何评估进展。
论文链接为 arxiv.org/pdf/2610.08761,项目网站为 veri-fine.github.io;工作由 Zewei Zhou 主导,合作者包括 Rachel Luo、Yulong Cao、ChaoweiX、Chensheng Peng、Boyiliee、tianran、Zheng Lian、yan_wang_9、Jiaqi Ma、iamborisi、wenhaoding95,并标注 NVIDIA DRIVE 与 NVIDIA AI 账号。
本站整理与观察
本站观察:该帖属于研究发布类介绍,未给出具体实验数字、基线对比或失败案例细节,因此“持续提升”目前仅为作者表述,尚不能视为已验证结论。
本站观察:VeriFine 的差异化点在于把评判器纳入进化对象,并在评判器成为瓶颈时引入人类反馈;这与仅优化策略的固定训练循环形成对照,但帖子未说明人类反馈的介入频率与成本。
本站观察:自动驾驶与机器人导航被列为评估场景,二者都涉及安全相关决策;帖子未披露安全指标或真实道路、真实机器人部署情况。
材料仅为作者发布的帖子,缺少论文正文、实验数据、基线设置与消融结果;文中性能提升、适用场景等均为原作者声称,未经本站独立验证。合作者姓名按原帖拼写保留,部分为社交账号名。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。