创作模型
NVIDIA 发布 Kumo Relational 关系基础模型,无需训练即可预测
完整中文导读
NVIDIA 发布 Kumo Relational,一个直接在关系数据库上做预测的预训练基础模型,单次前向推理即可输出流失、需求或欺诈等结果,无需任务训练和特征工程。
中文整理
作者 / 来源:Hugging Face · 原文时间:2026年10月22日 02:26(北京时间)
原作者信息要点
NVIDIA 发布 Kumo Relational,称其为预训练关系基础模型,可直接在企业数据库上做预测:给定预测查询,模型在推理时收集最多 10000 条历史样本作为上下文,单次前向传播输出流失、需求、欺诈等结果,无需任务特定训练、特征工程或表展平。
作者称 Kumo Relational 是首个在常见关系基准上以少样本方式超越监督机器学习的基座模型。在 15 个数据库的 41 项任务上,它优于监督式关系深度学习模型和专家特征工程的梯度提升树流水线;在 SAP SALT 企业基准上,其平均倒数排名(MRR)比 AutoGluon 集成高 8%。
模型可扩展到 5000 亿行以上的数据库,通过 NVIDIA 开源、GPU 原生的 structured-data-models 库或 NVIDIA NIM 提供,面向人类与智能体使用。论文链接为 arxiv.org/abs/2604.12596,文档位于 docs.nvidia.com/sdgm/rfm/overview。
作者将结构化数据基础模型类比语言和视觉领域的基座模型转变,提出三点理由:精度更高、部署更简单、可让智能体具备预测能力。文中称在 RelBench V1 分类任务上,Kumo Relational 比基于专家特征的梯度提升树平均高近 4 个 AUROC 点;在 SAP SALT 上开箱比 XGBoost 高 7 个 MRR 点,微调后高 13 个 MRR 点。
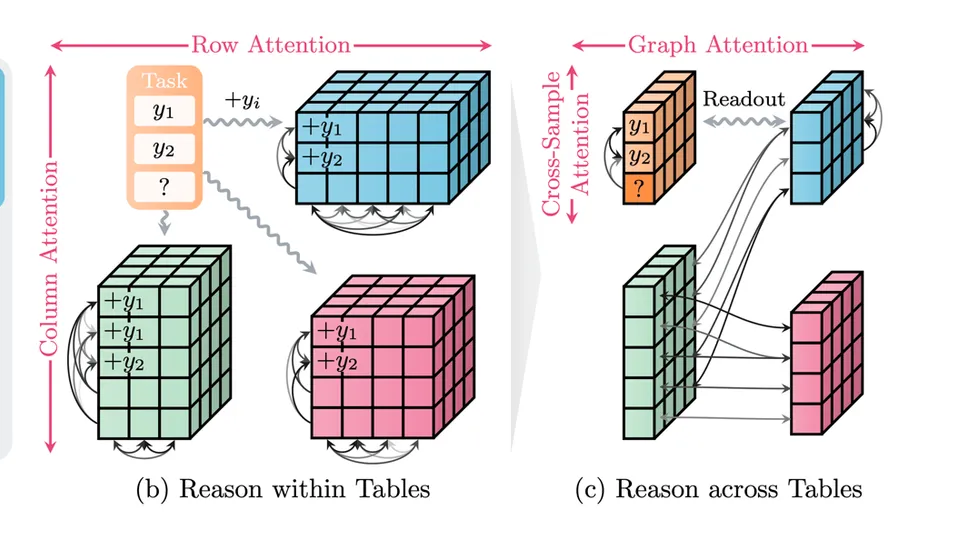
工作原理方面,模型直接操作数据库,尊重表、外键和时间戳,预训练于反映真实数据集的合成关系数据,通过上下文学习适配新任务。预测流程包括自动上下文生成、表内推理(列注意力和行注意力交替)和跨表推理(基于主外键的图注意力与跨样本注意力交错)。
构建方面,预训练数据完全合成,生成器基于 PluRel(Kothapalli 等,ICML 2026),分三阶段生成模式、外键链接和列值;作者称 PluRel 论文显示预训练损失随合成数据库增加呈幂律下降,收益可迁移到真实数据库。需要最高精度时也可在特定数据集和任务上微调。
评测覆盖 RelBench V1/V2、SAP SALT 和 4DBInfer 的 41 个基准、15 个关系数据库,均未在预训练中出现。作者称在 RelArena-α 排行榜上,Kumo Relational 开箱位于精度-效率帕累托前沿,约 17 秒、Elo 1842;最高分条目 rt-plurel 为 Elo 1878、约 7300 秒,慢约 430 倍。
作者还称在 SAP SALT 上,Kumo Relational 比大型 AutoGluon 集成 MRR 高 8%,比近期表格基础模型高约 25%,微调后对 AutoGluon 领先扩大到 16%;仅用 0.2% 训练数据作上下文仍表现良好,移除最多 75% 外键链接仍稳定,加入大量噪声列时性能下降很小。
作者列出的局限包括:在关系和时间动态有意义的数据上表现最佳;训练集很大时,任务特定监督模型可能仍优于上下文预测(基准中上下文最多 10000 例),微调正是为此设计;预测信号须在有限跳数内可达,建议从少量相关表的聚焦查询开始。
可用性方面,代码采用 Apache 2.0 许可,模型权重采用 OpenMDW License Agreement 1.1;库首次使用时从 Hugging Face Hub 下载权重,也可部署为 NVIDIA NIM 并通过 structured-data-models-client 调用。作者提供了论文、文档、GitHub、PyPI、权重和快速入门 notebook 链接。
本站整理与观察
本站观察:上述性能数字均来自原作者材料,包括 41 项任务、15 个数据库、8% MRR 提升、约 430 倍速度差、0.2% 上下文数据和 75% 外键移除等,均未在本站独立复现或核验。
本站观察:材料将 Kumo Relational 定位为“首个”在常见关系基准上以少样本超越监督学习的基座模型,这属于作者主张,需结合论文和第三方评测进一步确认。
本站观察:材料中论文编号 2604.12596 及 ICML 2026 引用指向未来时间,本站无法核实其实际发表状态,读者应以官方链接为准。
本站观察:作者同时给出“无需训练”和“可微调以追求最高精度”两种路径,实际部署时需根据任务数据规模在上下文学习与微调之间取舍。
本整理仅基于所提供的 NVIDIA 官方博客式材料,未独立验证任何基准数字、排行榜结果、论文内容或产品可用性;作者主张与已验证事实的区分受限于材料本身,缺少第三方复现和独立评测信息。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。