AI创新案例
Hugging Face 发布多框架 RL 指南,同一模型在不同 Agent 框架下得分 62% 与 33%
完整中文导读
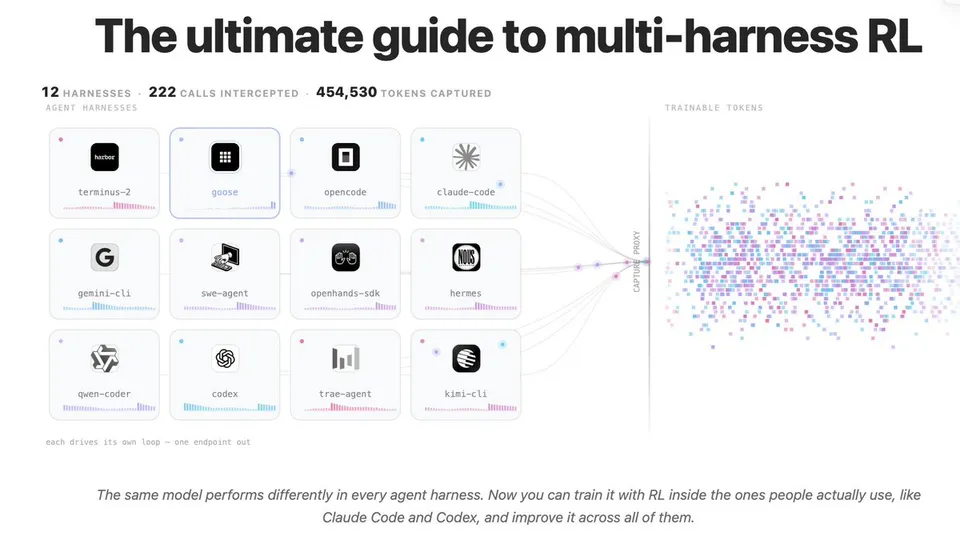
Hugging Face 团队发布多框架强化学习指南,指出同一模型、同一权重在不同 Agent 框架下得分从 62% 到 33% 不等。
中文整理
作者 / 来源:Hugging Face (@huggingface) · 原文时间:2026年10月2日 22:51(北京时间)
原作者信息要点
Hugging Face 发布多框架强化学习指南,作者为 Hugging Face 团队及 @adithya_s_k,内容全部开源。
核心方法:不改动 Agent 框架本身,而是将框架指向一个代理(proxy),由代理对接模型。该代理支持编码 Agent 使用的四种 API 格式:OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、Gemini。代理记录 vLLM 采样的精确 token id 与 logprobs,训练基于这些记录进行,无需修改 Claude Code、Codex 或 OpenCode 的任何代码。
关键数据:同一模型、相同权重,在不同 Agent 框架下得分分别为 62% 与 33%。
训练结果:跨 4 个框架同时训练,Liquid AI 的 LFM2.5-2.6B 从 42% 提升到 54%;工具调用次数减少 31%,原因是设置了以更少步骤完成任务的少量奖励。仅在 OpenCode 中训练,使 OpenCode 从 34% 提升到 58%,但多框架模型在所有框架上均有提升。
对比实验:团队尝试了常见的捷径,即用 Qwen3.8-27B 的 3,189 条成功 rollout 做微调,模仿学习在 47.5% 处停滞,低于两次 RL 训练结果。作者结论是复制更大的模型达不到效果,练习才行。
开源内容:OpenEnv 中的捕获代理、TRL 中的训练器、任务、SFT 数据、训练代码以及全部七个训练好的模型。
作者观点:Agent 将在数十种框架中运行,现在任何人都可以为每种框架训练开源模型。
本站整理与观察
本站观察:材料将“同一模型在不同框架下得分 62% 与 33%”作为问题背景,但未说明该分数对应的具体基准、任务集或评测条件,也未说明 62% 与 33% 分别对应哪个框架。
本站观察:材料中“31% fewer tool calls”与“小奖励鼓励更少步骤”之间的因果关系由作者给出,材料未提供消融实验或对照数据来单独验证该奖励项的贡献。
本站观察:模仿学习停滞在 47.5% 的结论基于 Qwen3.8-27B 的 3,189 条成功 rollout 这一单一设置,材料未说明该数据量或模型选择是否经过调优。
本站观察:材料称全部内容开源,并列出 OpenEnv、TRL、任务、SFT 数据、训练代码和七个模型,但未给出各开源组件的具体许可协议或仓库地址,仅提供指南页面链接。
材料为 Hugging Face 发布的宣传性帖子,未提供评测基准名称、任务细节、统计显著性、消融实验或复现步骤。62% 与 33% 的对应框架、分数含义及评测条件均未说明。所有训练结果与对比结论均来自作者单方陈述,未经本站独立验证。开源组件的许可与可获取性未在材料中确认。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。