AI教育实践
斯坦福 CS336 第 10 讲解析:Percy Liang 讲模型推理优化
完整中文导读
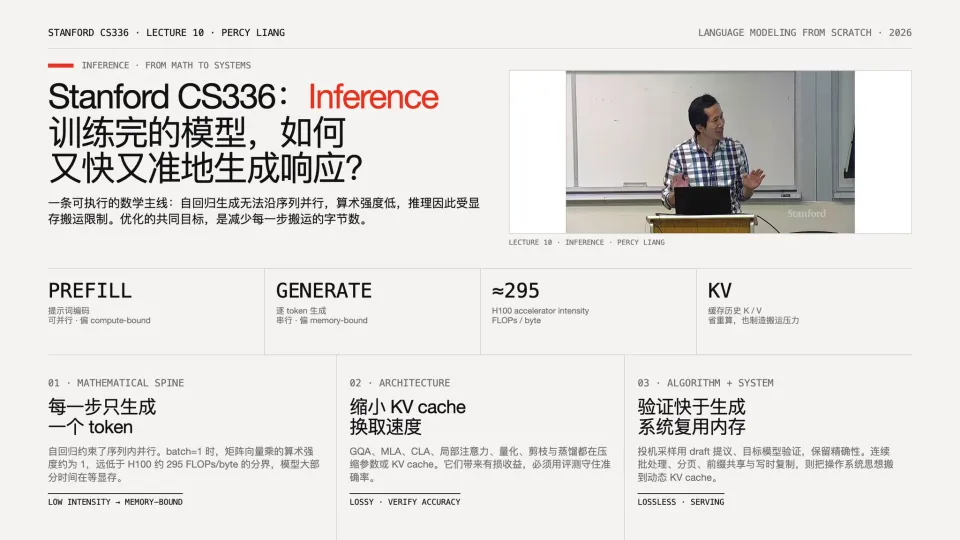
斯坦福 CS336 第 10 讲「Inference」由 Percy Liang 讲授,用一条数学主线串起架构、算法与系统层的推理优化手段,讲义以 sympy 可执行形式逐步推导并断言验证。
中文整理
作者 / 来源:meng shao (@shao__meng) · 原文时间:2026年10月18日 20:59(北京时间)
原作者信息要点
作者介绍斯坦福大学 CS336(Language Modeling from Scratch)第 10 讲“Inference”,该讲位于 Scaling Laws 与 Scaling Laws II 两讲之间,由 Percy Liang 讲授,主题是训练完成的模型如何又快又准地生成响应。
作者称讲义采用 CS336 的“可执行讲义”形式,公式用 sympy 逐步推导并断言验证;整讲逻辑链为:自回归导致无法沿序列并行,进而算术强度低、受 memory-bound 限制,因此一切优化归结为减少每步搬运的字节数。
作者将内容分为四层:架构层为有损手段,包括 GQA/MLA/CLA 降维、局部注意力截断、量化、剪枝蒸馏,目标是压缩 KV cache 与参数并用评测证明准确率未受损;算法层为无损手段,即投机采样,利用“验证快于生成”的不对称性换取加速;系统层包括连续批处理、分页、前缀共享、写时复制,被视为操作系统经典思想向 GPU 服务的迁移。
作者称全讲贯穿三组张力:延迟与吞吐(批大小)、速度与准确率(每项有损技术)、新颖性与可信度(称 GQA 与 MLA 论文结论相互矛盾)。
作者转述 Percy Liang 结尾的展望:KV cache 是 Transformer 对推理不友好的结构性根源,为推理从第一天起设计的架构(SSM、线性注意力、扩散式非自回归生成)可能是该领域最大的改进空间。
作者另分享两门斯坦福课程:CS336 由 Percy Liang 与 Tatsu Hashimoto 联合执教,从零构建完整语言模型;CS221(Artificial Intelligence: Principles and Techniques)由 Percy Liang 执教,用统一数学框架覆盖学习、搜索、MDP、博弈、贝叶斯网络、逻辑。作者称 Percy Liang 是 Stanford NLP 教授、Together Compute 联合创始人,并给出两门课的官网与 YouTube 播放列表链接。
本站整理与观察
本站观察:上述分层(架构、算法、系统)与“减少每步搬运字节数”的主线是作者对讲座的概括,材料未提供讲义原文或视频内容,无法独立核实各技术点的具体论述与数据。
本站观察:关于 GQA 与 MLA 论文结论“相互打脸”的说法出自作者,材料未给出论文名称或对比细节,应视为作者判断而非已验证事实。
本站观察:KV cache 是推理结构性瓶颈、SSM/线性注意力/扩散式生成是最大改进空间,属于讲座结尾的展望性观点,材料未附实验或量化依据。
本站观察:CS336 与 CS221 的课程定位、授课人与链接来自作者帖子;Percy Liang 的教授身份与 Together Compute 联合创始人身份同样为作者陈述,材料未提供第三方来源。
材料仅为作者对讲座的二手总结与课程推荐帖,未包含讲义原文、视频字幕或论文数据;文中技术分类、论文结论冲突、展望判断及人物头衔均无法独立验证,本整理未补充任何外部事实。
上下文来源:1
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。