AI 与硬件
Raspberry Pi 5 上的低功耗 CNN、VLM 与 SLM 工作负载:Sixfab AI HAT+ 与 DEEPX DX-M1M 实测
完整中文导读
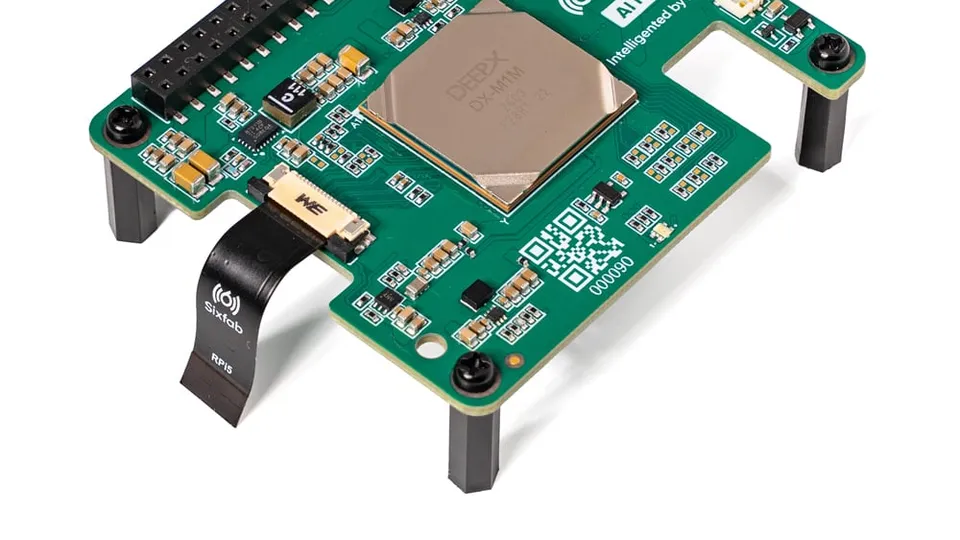
Sixfab AI HAT+ 为 Raspberry Pi 5 带来基于 DEEPX DX-M1M NPU 的 25 TOPS 加速,典型持续功耗约 3 W,可同时承载 CNN、紧凑 VLM 和 SLM 三类端侧负载。
中文整理
作者 / 来源:Ashley · 原文时间:2026年10月5日 19:59(北京时间)
原作者信息要点
文章作者为Ashley,发布在Raspberry Pi官方博客,主题是在Raspberry Pi 5上运行低功耗CNN、VLM与SLM工作负载,涉及Sixfab AI HAT+与DEEPX DX-M1M NPU。
Sixfab AI HAT+是面向Raspberry Pi 5的第三方AI加速板,基于DEEPX DX-M1M NPU,提供25 TOPS专用AI加速,典型持续NPU功耗约3 W,同时把Raspberry Pi的CPU留给摄像头处理、应用逻辑、连接和设备控制。
作者强调约3 W指25 TOPS DX-M1M选项的典型持续NPU功耗,不是整机墙插功耗,并建议开发者用实际摄像头、存储、工作负载和散热测量最终Raspberry Pi配置。
DX-M1M模块自带2 GB专用板载LPDDR4x,作者称其可同时支持VLM和SLM工作负载以及视觉模型。
DEEPX将INT8优化描述为精度感知的工程流程:从已知FP32精度基线和明确应用指标开始,用真实部署环境的代表性数据校准,通过DX-COM编译优化为可移植的.dxnn部署产物,再在最终Raspberry Pi系统上比较精度、延迟、功耗和热行为。
作者给出在Raspberry Pi 5(8 GB)上、运行Sixfab出货软件版本、对比DX-M1M与DX-M1 NPU的实测数据:mobilenet_v2 240×240下DX-M1M为2361 FPS、DX-M1为3223 FPS;deeplabv3plus 512×512下DX-M1M为155 FPS、DX-M1为231 FPS;Qwen3-1.7B 96 prefill tokens下DX-M1M首token时间599.04 ms、生成速度4.64 tok/s,DX-M1首token时间544.58 ms、生成速度11.60 tok/s。作者注明DX-M1使用LPDDR5而DX-M1M使用LPDDR4X,性能差异源于内存带宽。
软件栈包括:DX-COM将支持的ONNX模型优化编译为.dxnn产物;DX-RT通过C++或Python API在目标设备运行.dxnn模型;DX-Stream构建基于GStreamer的采集、推理和后处理管线;ModelZoo提供检测、分类、分割、姿态等预优化示例;dxrt-cli与dxtop用于查看设备状态、利用率、温度、时钟和内存。
作者给出从首次启动到首次推理的命令流程:sudo apt update && sudo apt install apt-repo-sixfab;sudo apt update && sudo apt install sixfab-dx dxrt-cli -s;run_hello_world运行打包示例;dxtop实时观察NPU。
作者列举的应用场景包括:工作台摄像头识别3D打印失败并发送带一行描述的截图;前门摄像头区分快递员、邻居的猫和徘徊者并每晚本地汇总事件;花园或宠物监控只对值得看的事件告警;以及智能摄像头持续本地检测、产线旁低功耗视觉质量与安全监控、机器人上感知与紧凑多模态智能同时Raspberry Pi运行ROS 2和控制逻辑、零售与智能空间的隐私感知占用和行为分析。
作者明确该加速板不适用于需要广泛世界知识、超长对话上下文或持续学习的应用,这类应用更适合计算和内存基本不受限的云端推理;DX-M1M最适合在摄像头或传感器旁运行范围 tightly scoped、始终在线的智能,满足隐私、延迟、离线运行和个位数瓦特功耗预算。
DX-AllSuite和ModelZoo在GitHub公开,DEEPX开发者门户提供文档、指南和支持渠道。25 TOPS的Sixfab AI HAT+ for Raspberry Pi 5现已从Sixfab发售,13 TOPS版本预计2026年底推出。
本站整理与观察
本站观察:原文的核心叙事是把边缘AI的评估标准从峰值TOPS转向持续功耗与热预算,约3 W的NPU功耗被作者视为比25 TOPS更具实际意义的设计约束。
本站观察:原文给出的性能数字均来自作者声称的Raspberry Pi 5 8 GB加Sixfab出货软件版本的实测,未提供第三方复现或完整测试条件,因此应视为原作者声称而非本站已验证事实。
本站观察:DX-M1与DX-M1M的对比中,内存类型差异(LPDDR5对LPDDR4X)被作者列为性能差异原因,但原文未给出带宽具体数值或更细的瓶颈分析。
本站观察:原文对VLM和SLM的描述偏重能力定位,未给出VLM具体模型、输入分辨率、精度指标或SLM的模型名称与量化细节,因此无法据此判断这两类工作负载的实际可用边界。
本站观察:作者把该平台定位为云端推理的补充而非替代,这一边界声明与边缘AI常见的隐私、延迟、离线需求一致,但原文未提供与云端方案的直接对比数据。
本整理仅基于原作者Ashley在Raspberry Pi博客发布的材料,所有性能数字、功耗数字、产品规格和发售时间均为原作者声称,未经本站独立验证。原文未提供完整测试环境、精度指标、模型细节或第三方复现结果,因此不应将上述数字视为已验证事实。原文中的命令和操作步骤属于原作者描述,本整理不构成操作建议。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。