创作模型
斯坦福与 NVIDIA 开源 CLM-8B 决策模型,比 Jev 快至多 9 倍
完整中文导读
斯坦福与 NVIDIA 开源 CLM-8B,这是一个基于 Qwen3-8B、在冻结主干上训练两个轻量投影头的对比语言模型(CLM),不生成文本,而是接收当前状态和候选动作并输出各选项概率,支持二选一、多选、有序打分和智能体验证。
中文整理
作者 / 来源:CuteGuy☣️ (@cutetoxicguy) · 原文时间:2026年10月22日 15:21(北京时间)
原作者信息要点
作者称斯坦福与 NVIDIA 开源了 CLM-8B,一个面向 AI 智能体决策的模型,不生成文字,决策速度比 Jev 快至多 9 倍。
CLM 的用法是接收当前情境和一组候选动作,为每个选项分配概率,而非生成解释。作者列出的适用场景包括二元决策(真/假、是/否、批准/拒绝)、多选决策、有序评分,以及智能体验证(在编码智能体生成的多个方案中选出最有希望的一个)。
架构方面,作者称其基于 Qwen3-8B,在冻结的主干之上训练两个轻量投影头,一个编码当前状态,另一个编码候选动作,模型比较两者的向量表示并把相似度分数转换为概率。作者还提到动作缓存:若智能体反复在同一组动作间选择,动作嵌入可只计算一次并复用,从而省去重复计算。
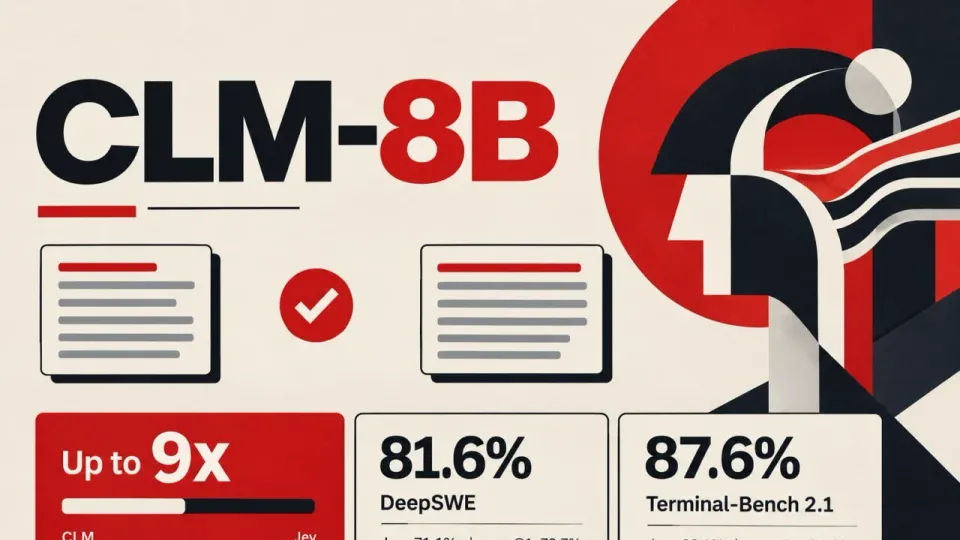
作者转述研究者报告的基准结果:在计算机使用、游戏和工具调用任务上,延迟比 Jev 低至多 9 倍,性能总体有竞争力;在约 1000 个已缓存候选动作间选择时快至多 13 倍;DeepSWE 上经微调的 CLM 通过在多份生成方案中选择,把编码任务成功率从 73.7% 提升到 81.6%;Terminal-Bench 2.1 上用同样的验证方式把成功率从 84.0% 提升到 87.6%。作者同时给出对照:在研究者的验证器评测中,Jev 在 DeepSWE 上为 71.1%,在 Terminal-Bench 2.1 上为 83.1%。
作者自行提示了结果局限:验证器对比只用了 38 个和 30 个任务的小规模留出集,且 CLM 接受了任务特定微调,因此不应把这些结果解读为普遍优越性的确证。
发布信息:模型以 Apache 2.0 许可提供,公开权重、推理代码和微调工具;运行参考实现需要 Linux、NVIDIA GPU,以及通过 vLLM 服务的 Qwen3-8B。作者给出的链接包括一个 Notion 研究文档页、Hugging Face 上的 Contrastive-LM 组织页,以及 GitHub 上的 Contrastive-LM/CLM 仓库。
本站整理与观察
以下为本站推论,非原作者陈述。该帖的核心主张可拆为两类:一是模型与方法的存在性及许可、依赖等技术事实,二是速度与成功率数字。后者均标注为研究者自行报告,帖子未提供独立复现,且作者已承认验证器对比样本量小、CLM 经过任务特定微调,因此 9 倍、13 倍等加速数字与成功率提升应视为待第三方验证的声明。
从描述看,CLM 的定位不是替代通用大模型,而是在智能体已知候选动作集合时承担“打分选择”环节,其速度优势部分来自动作缓存这一工程手段,而非纯粹的模型能力差异;这意味着加速幅度可能高度依赖任务中候选动作的重复程度。
帖子未说明 Jev 的具体版本、参数量或运行配置,也未给出延迟测量的硬件与批次条件,跨模型速度对比的可比性因此无法从材料中判断。
材料仅为一条社交媒体帖子,所有基准数字、架构细节与发布信息均转述自作者,未附原始论文或评测配置;Jev 的版本与测试环境、延迟测量方法、38 与 30 个任务留出集的具体构成均未说明,无法独立核实。本站观察部分为基于文本的推论,不构成对模型性能的验证。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。