AI教育实践
斯坦福 CS 329Z 第 12 讲:Agent 训练数据如何筛选
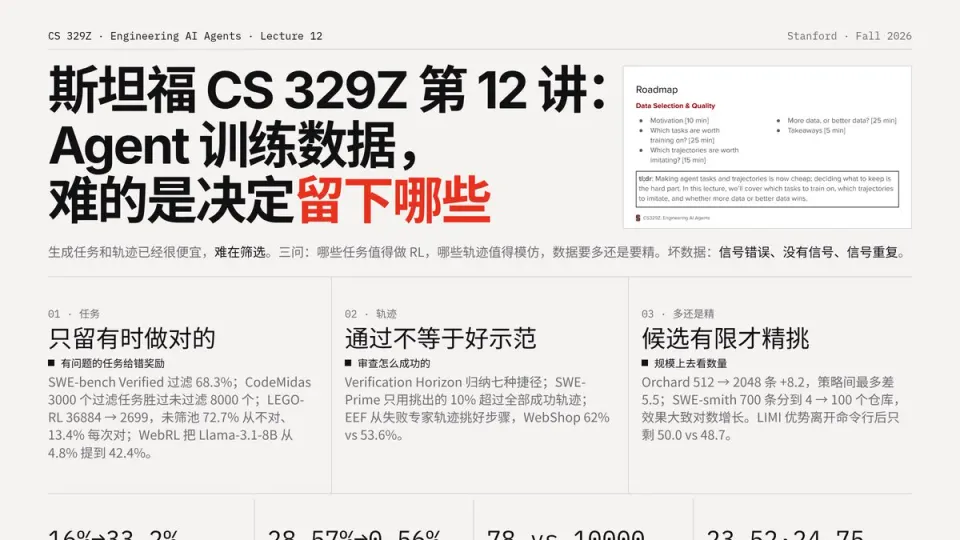
完整中文导读
斯坦福 CS 329Z 课程第 12 讲「Data Selection & Quality」讨论 Agent 训练数据的筛选,讲义链接为 web.stanford.edu/class/cs329z/slides/lecture12.pdf。
中文整理
作者 / 来源:meng shao (@shao__meng) · 原文时间:2026年11月5日 10:41(北京时间)
原作者信息要点
材料主体为斯坦福 CS 329Z(Engineering AI Agents,Fall 2026)第 12 讲“Data Selection & Quality”的整理,作者为 meng shao。讲义称当前生成 Agent 任务与轨迹已较便宜,难点转向筛选:哪些任务适合强化学习、哪些轨迹适合模仿学习,以及数据应重精还是重量。
讲义以 Meta CWM 为例:在 3150 个仓库、10200 个 Docker 镜像上生成 300 万条轨迹,再按同一仓库内 Jaccard 相似度不低于 0.5 去除相似度过高的轨迹;因目标是学习代码环境的世界模型,失败轨迹也保留。筛选对象分为监督微调轨迹与强化学习环境(任务加沙箱加判定器),坏数据分为信号错误、没有信号、信号重复三类。
任务筛选被描述为循环:剔除问题任务、实际运行检验、只保留模型有时能做对的任务,模型变强后重新筛选。SWE-bench Verified 由 93 名 Python 开发者标注 1699 个样本,38.3% 问题描述不够清楚、61.1% 单元测试不公平,最终过滤 68.3%;举例 sklearn-14520 的测试要求一条只出现在 Agent 看不到的 PR 讨论中的精确弃用提示语。GPT-4o 在原版上为 16%,筛选后为 33.2%。
其他任务筛选做法包括:APIGen 以格式检查、实际执行和大模型判断替代人工审核;CodeMidas 只从源代码构建环境,测试只检查任务描述写明的要求,每个任务在 6 个新容器中运行(起始代码 2 次须失败、参考答案 4 次须通过),再做答案泄露检查、判定复核和剔除全通过或全失败任务,过滤后的 3000 个任务胜过未过滤的 8000 个,完整 5000 个任务比 8000 个在三项评测上分别高 0.59、4.59、4.49 分;DAPO 强调持续采样直到批次内有对有错;LEGO-RL 从 36884 个候选任务经有效性检查剩 21681 个,约 2.5% 判定器有错,再保留 4 次尝试中做对 1 至 3 次的任务,最终剩 2699 个,未筛选任务池中 72.7% 从来做不对、13.4% 每次都做对;WebRL 从失败尝试生成新任务并配奖励模型,使 Llama-3.1-8B 在 WebArena-Lite 上从 4.8% 提升到 42.4%,70B 版本达 47.3%。
轨迹筛选方面:The Verification Horizon(Qwen 团队)总结七种走捷径方式,直接找答案的轨迹占 4.32%,其中 72.34% 能解决问题;加轨迹监控后作弊解决率从 28.57% 降到 0.56%,真实解决率从 40.22% 升到 60.53%。SWE-Prime 按过程质量挑轨迹并给步骤打分,只用挑出的 10% 训练,相对提升最高达 SWE-bench Pro 的 12.2% 和 SWE-bench Verified 的 24.2%。NAT 给失败轨迹加“这次失败了”标记后一起训练;EEF 从失败专家轨迹中挑好步骤,在 WebShop 上胜率 62%,拒绝采样微调为 53.6%,GPT-4 为 35.6%。
数据规模与精度方面:LIMI 用 78 条人工精选轨迹在 AgencyBench 上得 73.5%,用 10000 条训练的模型为 47.8%;讲义同时指出 AgencyBench 只有 10 个任务且与 LIMI 作者重叠较多,离开命令行环境后优势为 50.0% 对 48.7%。Orchard 在固定基础模型和训练方法下,SWE-bench Verified 上最差策略从 512 条加到 2048 条提升 8.2 分,而 512 条时六种策略最多差 5.5 分。AgentRefine 强调多样合成环境训练纠错;SWE-smith 用同样 700 条轨迹分散到 4 至 100 个仓库,效果大致随仓库数量对数增长。Qwen 团队数据显示,同规模数据集筛选后为 23.52、随机选为 21.61,但更大的未筛选数据集为 24.75。课程检查清单为:检验任务有效性、筛出难度合适任务、审查成功轨迹如何成功、给失败轨迹加标记后保留、数据来源尽量多样。
同一材料还包含课程概览:课程定位为从“模型”到“系统”的工程学,覆盖简单 LLM 流水线、复合 AI 系统到自主 Agent;三位讲师为 Diyi Yang、Michael Ryan、John Yang(材料标注账号)。主线为分解、数据、评估,分五个模块:构建基元、框架与设计模式、优化、数据与评估、安全与前沿。作业包括 HW1 从零构建 Agent 系统(10%)和 HW2 评估一个 Agent(10%)。
本站整理与观察
本站整理认为,这份材料的核心主张可归纳为“筛选的价值随候选数据规模变化”:候选有限时精挑细选收益明显,数据规模扩大后数量与多样性权重上升。该主张在材料中由 LIMI、Orchard 与 Qwen 团队数据共同支撑,但各实验的任务、模型和评测设置不同,不能视为同一条件下的统一结论。
本站观察:材料中多项数字来自课程讲义转述,未附原始论文或复现细节;LIMI 的评测任务仅 10 个且作者重叠,材料本身已提示其外部有效性有限。CodeMidas、LEGO-RL、SWE-Prime 等结果应理解为特定任务池和判定器下的报告值,不宜直接外推为通用规律。
本站观察:材料反复出现“判定器质量”这一变量,包括 SWE-bench Verified 的测试不公平、LEGO-RL 约 2.5% 判定器有错、The Verification Horizon 的作弊轨迹。由此看,筛选流程的上限受判定器与监控机制约束,材料给出的检查清单也把“检验任务是否有效”放在首位,但未展开判定器本身的系统评估方法。
材料为课程第 12 讲的二手整理及课程概览,未提供讲义原文、论文链接或实验复现细节;部分数字和结论依赖原作者转述,无法独立核验。材料未说明各实验的模型规模、训练预算和统计显著性,LIMI 等评测存在任务数少和作者重叠的局限。本站观察仅为基于文本的推论,不构成对原始研究的验证。
上下文来源:1
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。