AI教育实践
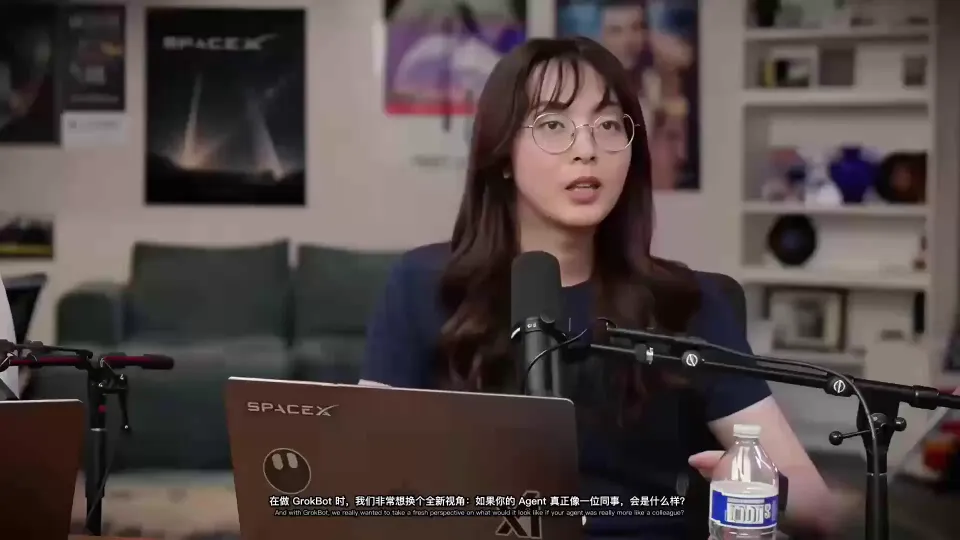
Lauren Tan 分享在 Cursor 中使用 AI 编程 Agent 的经验
完整中文导读
Lauren Tan 在视频中分享她在 Cursor 使用 AI 编程 Agent 的经验,由 Tao Wang 抓取字幕并翻译成双语字幕。她认为要让 Agent 可靠自主完成工作,工程师需先建设验证工具、项目知识和自动化约束,并给出从观察失败、补充 Skill、建立运行验证到把关键规范变成 CI 检查的实践顺序。
中文整理
作者 / 来源:Tao Wang (@Tao100086) · 原文时间:2026年11月1日 09:41(北京时间)
原作者信息要点
Lauren Tan(@poteto)在一个视频中分享她在 Cursor 使用 AI 编程 Agent 的经验。Tao Wang 称其用工具抓取字幕、翻译并重新烧录了双语字幕。
贯穿分享的观点是:要让 Agent 可靠地自主完成工作,工程师需要先建设验证工具、项目知识和自动化约束,信任来自这些机制持续产出的可靠结果。
她描述从紧盯一两个 Agent,到让它们独立完成任务,再到自动合并代码的路径;自述曾一个月合入约 1,000 个 PR,也有睡醒后发现 20 多个 PR 已合入的经历,并称这些成果建立在前期大量建设工作之上。
她强调 Agent 应能启动应用、操作界面、复现问题、查看日志和性能数据并检查修改后的表现;并提出 Feature Map(功能地图),告诉 Agent 功能位置、进入方式、快捷键和界面元素定位方法。她区分:验证用于判断功能是否解决问题,代码是否清晰易维护还需其他机制。
她把 Agent 比作很会写代码但刚入职五秒钟的新同事,Skill 用于写下业务背景、标准和操作方法;其 PStack 工具集来自持续观察失败并补充流程。Skill 本身也需评估:设定评分标准,让多个 Agent 或模型执行任务、交叉检查,再据表现修改。
她建议先在本地建立可靠流程,再扩展到云端和自动化;举例名为 Benny 的 Agent 接收 Bug 报告、在云端启动应用并尝试复现,有一次确认问题在主分支已修复、只需发布新版本。她明确不建议在基础能力尚不可靠时直接启动成百上千个 Agent。
她认为有成熟规范和检查机制的老项目可能比毫无约束的新项目更适合 Agent;自述为迁移到新架构进行了超过 600 个 PR 的改动,并鼓励拆成目标单一的小 PR,未规定统一代码行数上限。
她主张把重要规范变成自动执行的检查,落实到项目结构、编译检查和 CI;介绍的 Dune 架构会集中存放同一功能代码并检查模块引用关系,例如限制界面渲染部分引入繁重计算。她自述在项目中禁用了 useEffect 和代码注释,并称这是针对其项目失败模式的具体规则。
她承认自己拥有非常充足的 Token 资源,其他人不应原样照搬;重构、编写 Skill 和建立验证体系都需要时间与费用,分享中没有给出普通团队可直接套用的成本预算。
她用“主厨”作比喻:工程师不必亲自做每一道菜,而要设计厨房、制定流程、分配任务并保证出品质量;当工具、架构和检查足够完善后,产品经理、设计师也能借助 Agent 修改功能和修复问题。
本站整理与观察
本站观察:这份材料是对一场视频分享的二手转述,包含时间戳和自述数据,但未提供视频链接、PR 统计口径或成本数据,无法独立核验。
本站观察:可提炼的实践顺序为——观察失败、补充项目知识和 Skill、建立实际运行验证、评估并改进流程、把关键规范变成自动检查、逐步扩大自主工作范围。该顺序是本站根据原文第 8 点末尾的整理归纳,并非作者逐字表述。
本站观察:禁用 useEffect 和代码注释属于作者针对其项目失败模式的具体规则,材料未说明其适用边界,不宜直接视为通用最佳实践。
材料为单一二手转述,缺少原始视频、PR 统计口径、成本数据和可复现细节;作者自述的约 1,000 个 PR、20 多个 PR、600 多个 PR 等数字均无法独立验证。本站观察仅为基于文本的推论,不构成对作者观点的完整还原或效果保证。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。