研究前沿
MIT Media Lab 研究:能力更强的语言模型可能不再需要多智能体协作
完整中文导读
MIT Media Lab 在 Nature Machine Intelligence 论文中通过 260 组智能体配置的受控评测发现,更强的单智能体可能不再从协作中获益,单智能体成功率约 45% 的能力饱和阈值可预测协作是否有益,在 16 组模型-基准配置中方向吻合率达 94%。
中文整理
作者 / 来源:MIT Media Lab Projects · 原文时间未提供
原作者信息要点
作者在 Nature Machine Intelligence 发表论文《Capable language models can outgrow the benefits of collaboration》,对 260 种智能体配置进行受控评估,结论是更强的单智能体可能不再需要协作带来的收益。
研究聚焦三类任务:与外部环境的持续多步交互、部分可观测条件下的迭代信息收集、基于环境反馈的策略调整。
评估使用六个基准:BrowseComp-Plus(网络研究)、Finance Agent(金融分析)、PlanCraft(规划)、WorkBench(职场工具使用)、SWE-bench Verified(软件工程)、Terminal-Bench(命令行任务)。在固定任务提示、工具访问和每系统算力上限的前提下,改变模型能力与协调结构。
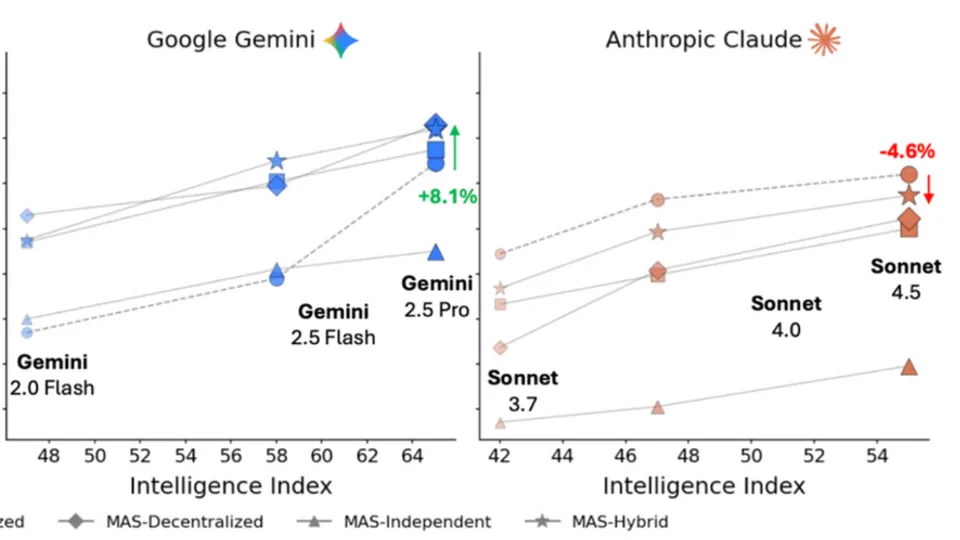
五种架构:单智能体(SAS)、独立(并行探索、不交换消息、输出合并但不交叉验证)、集中式(编排者委派、审查并综合工作者输出)、去中心化(同伴辩论、投票聚合)、混合(编排者指挥且智能体之间交换信息)。
主要发现:在 OpenAI、Google、Anthropic 模型家族中,更强模型总体表现更好,但增加智能体并未可靠地超过其单智能体基线。单智能体表现是唯一同时通过基准聚类推断和多重比较校正的预测因子。
作者拟合出一条决策规则,识别出约 45% 单智能体成功率的“能力饱和阈值”。高于该水平时,规则预测增加智能体带来零收益或负收益;在 SWE-bench Verified 和 Terminal-Bench 的 16 个模型—基准配置中,该规则与观察到的多智能体收益方向一致的比例为 94%。作者强调这是经验性选择规则,不是通用截断值,且这两个基准每个配置仅用 20 个任务实例,单项估计仍不确定。
分领域结果:Finance Agent 上集中式协调将平均表现从 34.9% 提升到 63.1%,相对提升约 80.8%;PlanCraft 上所有测试的多智能体架构都降低表现,相对下降 39%–70%;SWE-bench Verified 各变体呈小幅到中等下降;Terminal-Bench 结果不一。
错误放大:轨迹级错误放大指标显示,独立系统放大因子为 17.2,集中式系统为 4.4。作者说明该数值不代表最终答案出错概率的倍数,描述的是执行层面的错误动态,与任务失败率不同。
预测模型:使用模型能力、智能体数量、工具数量、单智能体表现及协调属性(含开销与错误放大)拟合,交叉验证 R²=0.373,用智能体任务表现衡量能力时升至 0.413;在评估领域内的留出配置中,选出最佳架构的比例为 87%。作者指出,该架构选择结果与阈值规则的 94% 是两回事,二者都不能保证在全新领域可靠预测——整基准留出时绝对表现预测很差。
作者建议实践者从强单智能体基线出发,测量协调成本,检验委派或验证是否带来足够收益。作者致谢 Google Research、Google DeepMind 及学术合作机构。
本站整理与观察
本站观察:该研究的核心变量是“单智能体基线能力”而非智能体数量本身,这为多智能体系统的适用边界提供了一个可测量的切入点。
本站观察:集中式协调在金融分析类任务上收益明显、在规划类任务上普遍受损,提示架构收益高度依赖任务结构,而非存在普适的最优架构。
本站观察:错误放大指标区分了执行层协调失败与最终任务失败率,若被后续工作复现,可能成为评估多智能体系统稳健性的补充维度。
本站观察:作者给出的实践路径——先测强单智能体基线、再量化协调成本、最后验证委派或验证的净收益——与当前工程实践中“默认多智能体”的倾向形成对照。
材料为作者自述的研究摘要,未提供论文全文、原始数据、统计代码或同行评审细节;文中所有数字、阈值、比例和结论均来自作者陈述,本站未独立验证。作者已声明 45% 阈值是经验性选择规则而非通用截断值,且部分基准每配置仅 20 个任务实例,估计存在不确定性;工具协调成本相关交互在基准聚类校正后不具统计显著性,作者仅作为描述性模式报告。预测模型在整基准留出时绝对表现预测较差,说明结论不宜外推到未测试领域。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。