AI 与硬件
CMU 机器人研究所:多智能体强化学习的分布式协同策略学习
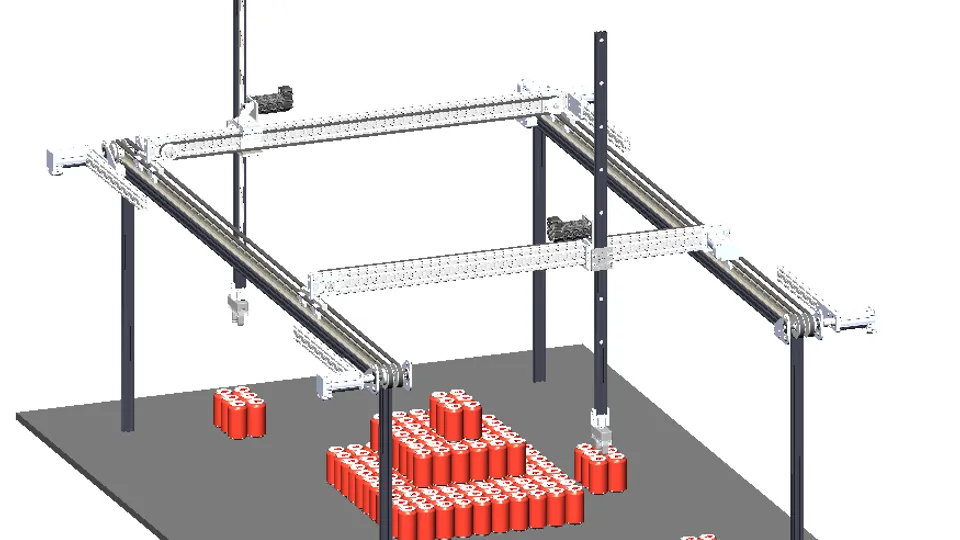
完整中文导读
CMU 机器人研究所提出一种完全分布式、可扩展的多智能体强化学习框架,多个智能体在共享环境中学习同一套协同策略,训练完成后可部署到任意数量的智能体上,几乎无需额外训练。该方法将单智能体 A3C 算法扩展为多智能体版本,采用全去中心化架构,各智能体运行相同策略副本且不显式通信。研究以受哈佛 TERMES 项目启发的多机器人搭建任务为测试场景,该任务奖励稀疏且延迟。
中文整理
作者 / 来源:CMU Robotics Institute Projects · 原文时间未提供
原作者信息要点
材料来自卡内基梅隆大学(CMU)机器人研究所的一个项目介绍页面,主题为多智能体强化学习(MARL)中的分布式协同策略学习。
作者指出,单智能体人工智能尤其是深度强化学习近年取得大幅进展,大量研究者正尝试把单智能体方法扩展到多智能体系统;但单智能体方法的自然扩展在多智能体问题上会失效。
作者给出的主要原因是联合 MARL 问题很少能被求解,核心困难在于智能体必须探索高维的状态-动作空间。在此背景下,研究社区一直在寻求分布式解决方案。
该项目开发一个完全分布式、可扩展的学习框架:多个智能体在共享环境中学习一个共同的协同策略,学到的策略随后可部署到任意数量的智能体上,几乎不需要额外训练。
研究聚焦多机器人建造问题,灵感来自哈佛的 TERMES 项目:简单机器人需要收集、搬运并放置简单积木元素,以搭建用户指定的三维结构。
作者称,把该问题放入强化学习框架后,它是一个非常困难的博弈,奖励稀疏且延迟,因为机器人需要搭建脚手架才能到达结构的更高层并完成建造。
项目采用完全去中心化架构:每个智能体运行同一策略的相同副本,智能体之间不显式通信,但仍能实现共同目标。策略是集中学习的,即训练期间所有智能体都对该策略作出贡献。
策略学习完成后可部署到任意数量的智能体上,并让每个智能体把其他智能体视为系统中的移动特征。
为此,作者扩展了单智能体异步优势演员-评论家(A3C)算法,使多个智能体能在共享环境中学习同质、协同的策略。材料还提供了一个基线视频链接。
本站整理与观察
本站整理:材料属于项目介绍性陈述,未给出实验数据、成功率、训练规模或对比基线结果,因此无法据此判断该框架的实际性能。
本站观察:作者把“完全分布式执行”与“集中式训练”结合,这一设定与集中训练、分散执行(CTDE)的常见思路相近;但材料没有使用 CTDE 这一术语,也未说明训练时智能体之间如何共享信息。
本站观察:材料强调策略可部署到任意数量智能体且几乎无需额外训练,这属于作者声称的可扩展性目标,尚缺少已验证事实支撑。
本站观察:多机器人建造任务被描述为奖励稀疏且延迟,并需要搭建脚手架,这提示该任务对探索和信用分配要求较高;材料未说明具体如何缓解这些问题。
本站观察:将其他智能体视为“移动特征”意味着策略输入包含对同伴的观测,但材料未说明观测范围、是否部分可观测,也未说明同质策略在智能体数量变化时的表现。
材料为项目介绍页面,缺少实验设置、定量结果、对比方法和发表信息;作者关于可扩展性与部署便利性的表述属于项目声称,未在本材料中验证。材料未提供作者姓名,也未说明训练所用智能体数量、环境规模和计算资源。
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。