AI创新案例
DeepEval 团队发布 JevEval:用 Jev 替代生成式 LLM 当评估裁判
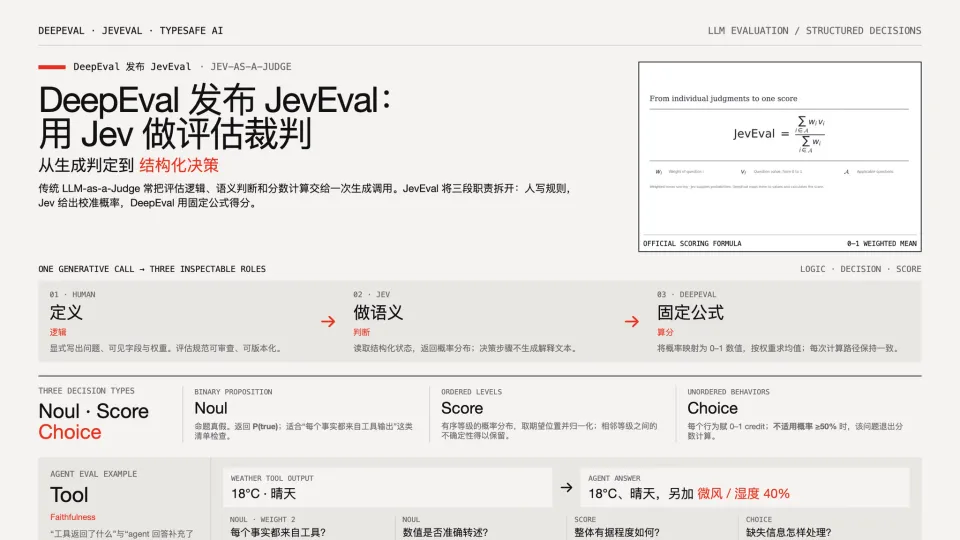
完整中文导读
DeepEval 团队发布 JevEval,用 Jev 替代生成式 LLM 担任评估裁判,把 LLM 评估从生成判定改为结构化决策。传统 LLM-as-a-judge 让生成式模型在一次调用里同时定义评估逻辑、做出判断并算出分数,导致分数差异不可解释、同一输入两次运行结果不稳定。
中文整理
作者 / 来源:meng shao (@shao__meng) · 原文时间:2026年10月13日 18:01(北京时间)
原作者信息要点
DeepEval 团队发布 JevEval,主张用 Jev 替代生成式 LLM 充当评估裁判,把 LLM 评估从“生成判定”改为“结构化决策”。博客地址为 https://deepeval.com/blog/introducing-jev-as-a-judge。
作者称传统 LLM-as-a-judge 让一个生成式模型在一次调用中同时完成定义评估逻辑、做出判断、算出分数三件事,由此带来两个问题:不可解释,即 0.71 与 0.66 的差异来源说不清;不稳定,即同一输入两次运行可能给出不同分数,且让 LLM 凭空编出“1 到 10 的打分”更不稳定。
JevEval 的解法是把三者分离:评估逻辑由人负责,显式、可审查;语义判断由 Jev 负责,返回概率分布而不生成文本;分数计算由 DeepEval 固定公式负责,具有确定性。
作者列出三种决策类型:Noul(命题真假),二元命题返回 P(true),适合清单式检查,如“回答中每个事实都来自工具输出”;Score(有序等级),如“全编造 → 大部分编造 → 大部分有据 → 全部有据”,返回各等级概率后取期望位置归一化,保留相邻等级间的不确定性;Choice(无序行为选择),给每个选项赋 0–1 的 credit,支持“不适用”,当概率 ≥50% 时该题不计分,作者称这可避免因问题不适用而惩罚被评对象。
作者以 Tool Faithfulness 举例:天气工具返回 18°C、晴天,但 agent 的回答额外编造了“微风、湿度 40%”。作者称传统裁判只能给含糊总分,JevEval 把它拆成四个显式问题:事实是否都来自工具(权重 2,因为幻觉是最重要的失败模式)、数值是否转述准确、整体有据程度、如何处理工具未提供的信息。作者强调权重和优先级写在代码里而非隐含在提示词中,并称这是其最大的工程价值。
引用 @Sumanth_077 的说法:JevEval 用 Jev 作为自定义 LLM 评估的裁判,而不是每次评估都依赖另一个生成式 LLM。流程是定义希望评估器做出的确切决策,Jev 评估每一项并返回概率,DeepEval 用这些结果计算最终分数。对 AI agent 可评估 trace 本身,检查是否选对工具、是否遵循预期动作顺序、是否真正完成任务。Jev 负责语义判断,评分逻辑留在模型之外。
@Sumanth_077 称与普通 LLM-as-a-judge 的主要区别在于:生成式裁判往往要自行解释评分标准、推理回答并生成评估;JevEval 则预先定义决策结构。可以为不同检查分配不同权重,或在所有要求都必须通过时使用 strict_mode。若 agent 工作流某部分更重要,可直接反映在评分逻辑中,而不必把整个评估交给裁判模型。
@Sumanth_077 列出的关键能力包括:用 Jev 评估 agent 输出与 trace;把自定义检查定义为有界决策;使用是/否、评分和封闭式选择题;对不同检查加权或要求全部通过;评估单轮输出与多轮对话。其结论是:如果已经知道需要检查什么,就可预先定义这些决策,让 Jev 处理语义判断,并保持最终评分确定性。
本站整理与观察
本站观察:上述内容主要来自 DeepEval 博客介绍与 @Sumanth_077 的帖子,属于发布方与引用者的主张,材料中未提供独立第三方复现、基准对比或稳定性实测数据,因此“不可解释”“不稳定”等对传统方法的描述应视为作者观点而非已验证事实。
本站观察:JevEval 的核心设计取向是把评估拆成可审查的决策结构与确定性的评分公式,把语义判断压缩为概率输出。这一取向在工程上便于把权重、优先级和 strict_mode 等规则显式写入代码,但材料未说明 Jev 本身的准确率、概率校准质量、延迟与成本,也未说明与生成式裁判相比在何种任务上更优。
本站观察:材料给出的 Tool Faithfulness 示例中,四个检查项与权重 2 的设定属于作者举例,并非通用标准;实际使用时如何选取检查项、如何设定权重与阈值,材料未给出系统方法。
本站观察:Choice 类型中“不适用”概率 ≥50% 即不计分的规则,以及 Score 类型取期望位置归一化的做法,均为材料所述机制,其在不同数据集上的行为与偏差未在材料中验证。
材料仅包含 DeepEval 博客链接与 @Sumanth_077 的帖子文本,未提供博客全文、Jev 模型技术细节、基准测试、消融实验、第三方复现或与生成式裁判的定量对比。因此本整理只能转述发布方与引用者的主张,无法核实 JevEval 的实际效果、稳定性提升幅度、成本变化及适用边界;文中所有“本站观察”均为基于现有材料的推论,不构成已验证结论。
上下文来源:1
本文为来源内容的中文摘要与整理,不代表原文全文翻译。完整信息请查阅来源原文。